
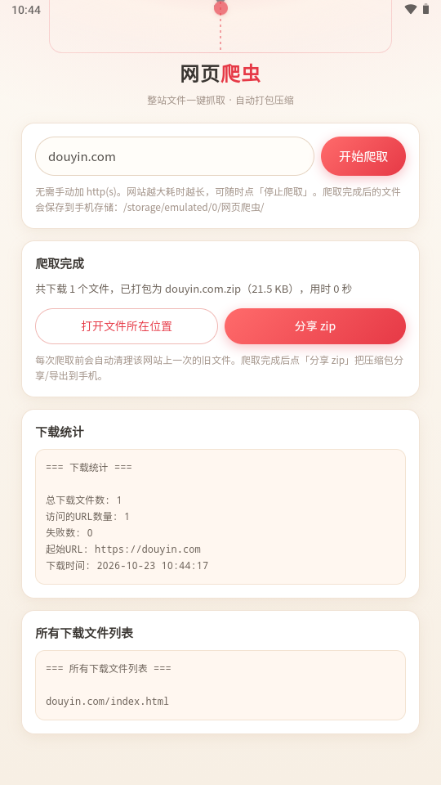
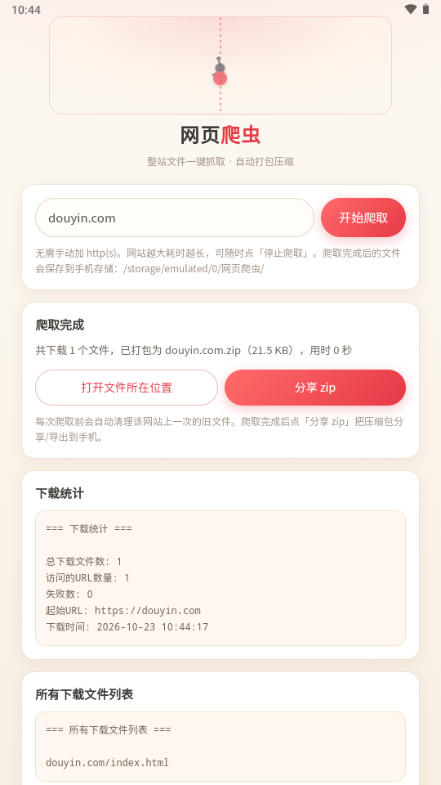
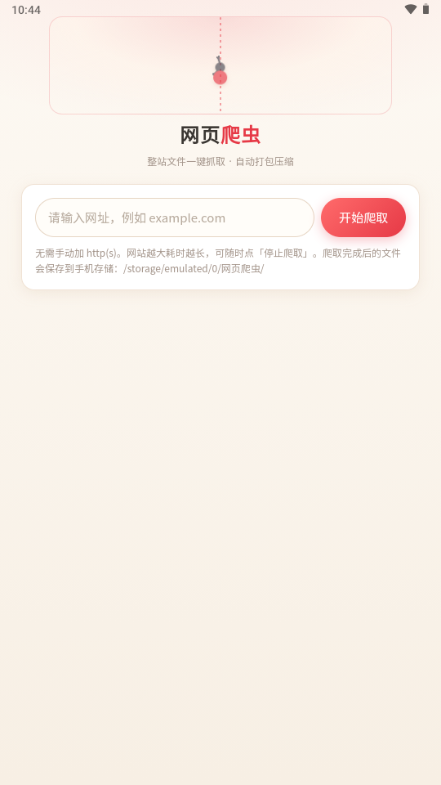
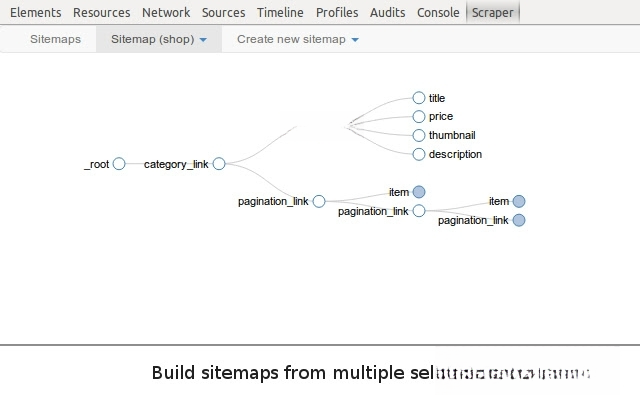
网页爬虫是一款面向普通用户的轻量级网络数据采集工具,它把原本需要编写代码才能完成的网页信息提取工作,变成了可视化、可配置的简单操作。用户只需输入目标网址,设定需要抓取的字段规则,软件便会自动模拟浏览器访问、解析页面结构,并将结果整理成表格或文本文件保存到本地。对于需要批量收集商品信息、文章标题、公开联系方式、行业资讯等场景,网页爬虫能够显著降低人工复制粘贴的时间成本。软件界面简洁,运行稳定,支持断点续采与失败重试机制,即便网络出现短暂波动也不会导致任务前功尽弃。同时,网页爬虫内置了基础的访问频率控制与请求头伪装选项,帮助用户在合规前提下更顺畅地获取公开网页内容,是数据整理爱好者与办公人员值得尝试的辅助工具。
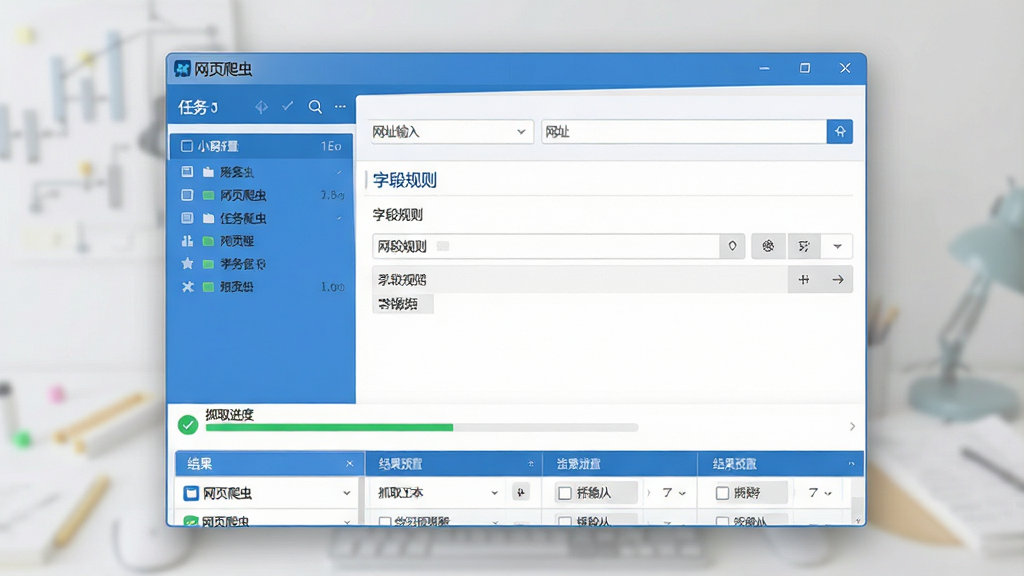
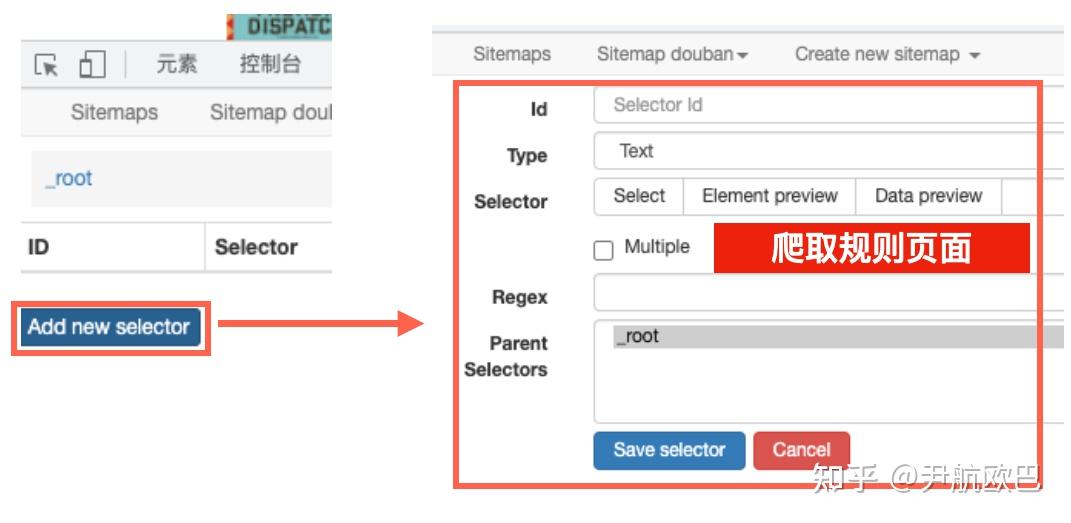
网页爬虫摒弃了传统爬虫工具依赖代码脚本的繁琐流程,将字段提取规则转化为勾选与填写的表单操作。用户打开目标页面后,软件会自动识别页面中的标题、链接、图片、正文段落等常见元素,并以列表形式呈现,用户只需勾选需要采集的内容类型,即可完成规则设定。对于结构特殊的页面,还支持手动选取页面区域进行精准定位,降低了非技术用户的使用门槛,让数据采集变得像使用浏览器插件一样直观。
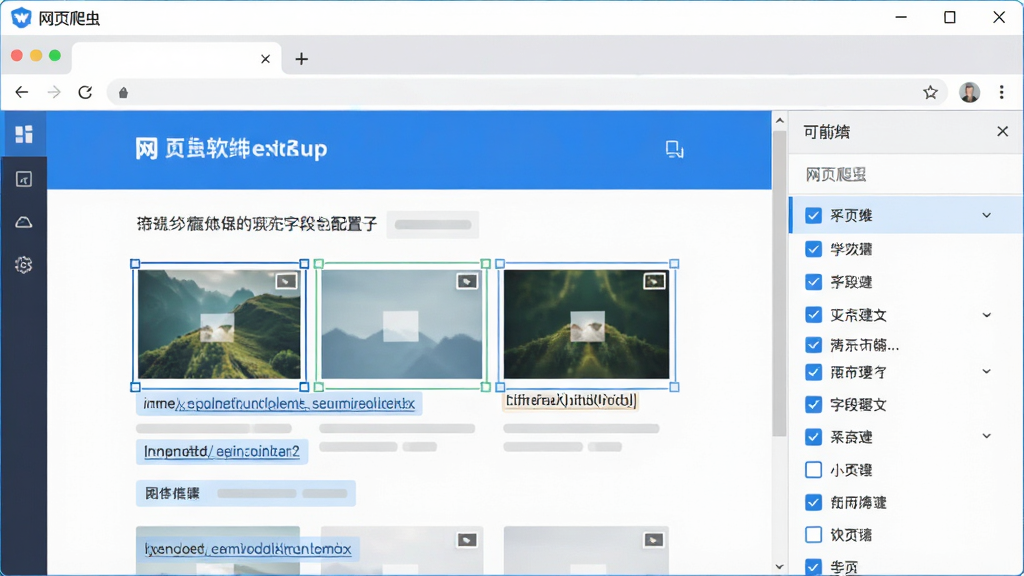
采集完成的数据并非只能停留在软件内部查看,网页爬虫提供了多种导出方式以满足不同后续处理需求。用户可以将结果一键导出为Excel表格、CSV文件、TXT纯文本或JSON结构化数据,方便导入到办公软件、数据库或数据分析工具中继续使用。导出时支持自定义列顺序与编码格式,避免出现中文乱码问题,对于需要批量整理资料的用户来说,这一功能大幅提升了数据流转效率。
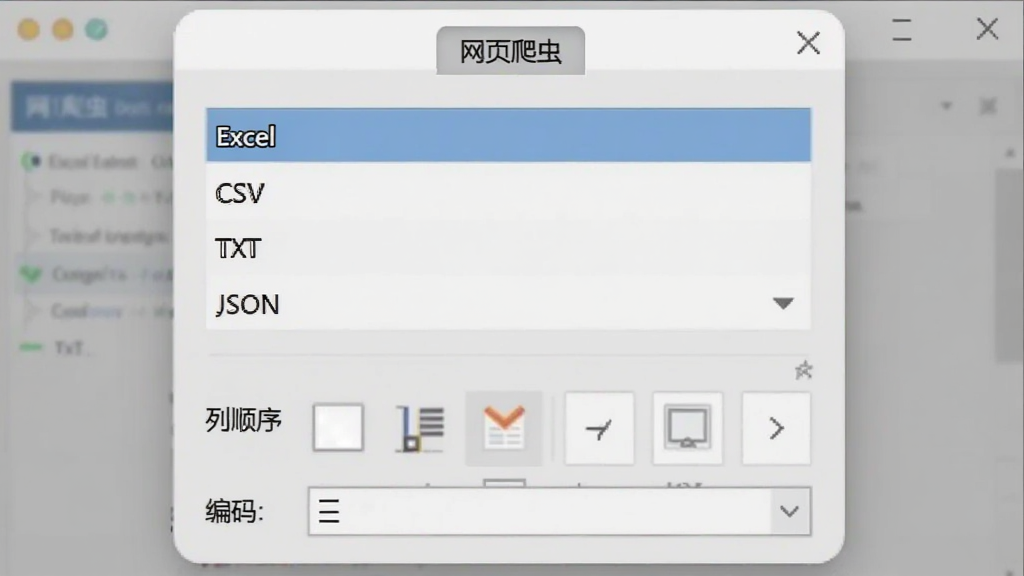
为了避免对目标网站造成过大访问压力,网页爬虫内置了请求间隔控制与并发数调节机制。用户可以根据目标站点的实际情况设置每次请求之间的等待时间,软件会严格按照设定节奏依次访问页面,避免因请求过于密集而触发网站的反爬限制。同时,软件支持失败自动重试与断点续采,当某个页面因网络超时或临时错误未能成功获取时,会自动记录并在后续重新尝试,确保采集任务的完整性。
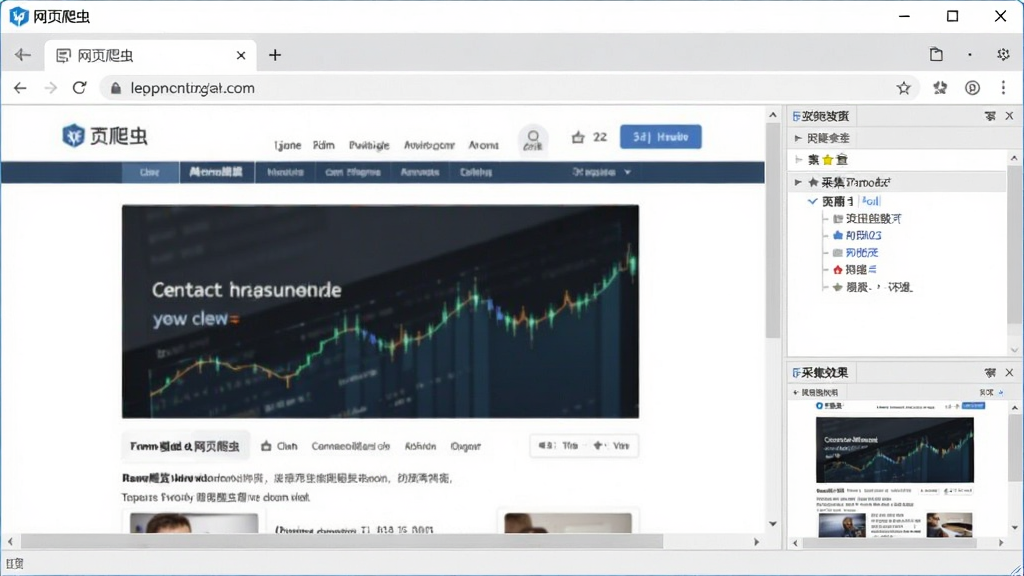
网页爬虫集成了轻量级浏览器内核,用户可以在软件内部直接打开目标网页进行浏览与规则调试,无需在外部浏览器与爬虫工具之间反复切换。内置浏览器支持页面缩放、元素审查与实时预览采集效果,用户在配置规则后可以立即看到哪些内容被成功匹配,哪些字段需要调整,做到所见即所得。这一设计尤其适合需要反复调试采集规则的用户,减少了试错成本与操作步骤。
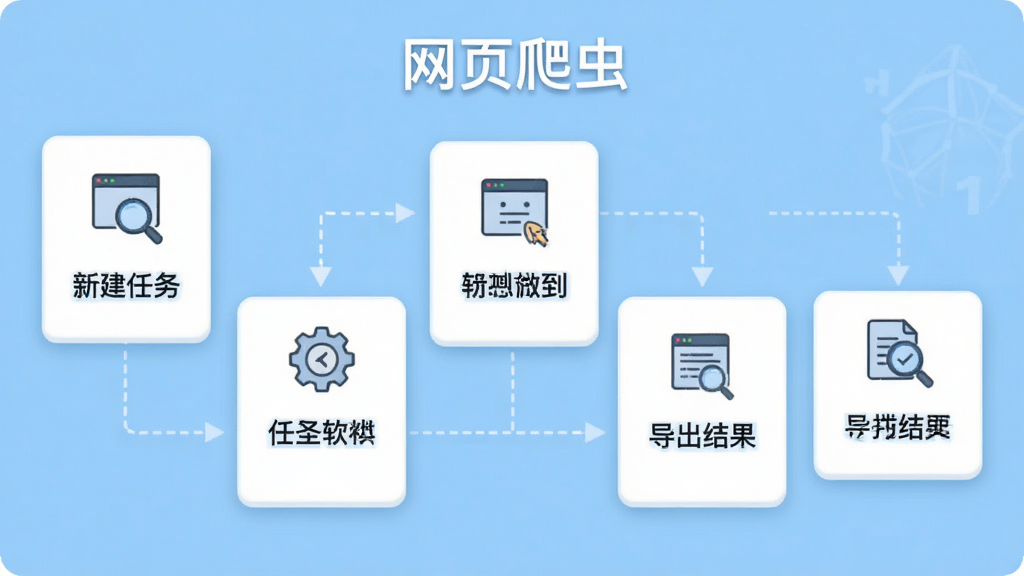
| 操作环节 | 具体说明 | 注意事项 |
|---|---|---|
| 新建任务 | 点击主界面左上角新建按钮,输入目标网址并命名任务,选择需要采集的页面范围 | 建议先用少量页面测试规则,确认无误后再扩大采集范围 |
| 配置字段 | 在内置浏览器中加载页面后,勾选标题、链接、图片、正文等字段,或手动框选页面区域 | 字段名称建议使用中文以便后续识别,避免使用特殊符号 |
| 设置调度 | 调整请求间隔时间与并发数量,开启失败重试选项,设定最大重试次数 | 请求间隔不宜过短,建议不低于两秒,以免对目标网站造成压力 |
| 启动采集 | 点击开始按钮,软件按设定规则自动访问页面并提取数据,进度条实时显示完成比例 | 采集过程中可随时暂停,已采集的数据不会丢失 |
| 导出结果 | 任务完成后点击导出按钮,选择Excel、CSV、TXT或JSON格式保存到本地 | 导出前可预览数据,确认列顺序与内容无误后再保存 |
初次使用网页爬虫时,建议先在少量页面上测试采集规则,确认字段匹配准确后再扩大任务规模,避免因规则错误导致大量无效数据。
高危注意:切勿将请求间隔设置为零或过短时间,密集请求容易触发目标网站的反爬机制,导致IP被临时封禁,严重时可能影响正常访问。
优化技巧:合理利用内置浏览器的元素审查功能,先观察页面结构再配置字段,可以显著提高采集准确率;导出数据时优先选择UTF-8编码,避免中文乱码。
温馨提示:建议将采集任务安排在网络空闲时段运行,减少因网络波动导致的请求失败;定期清理已完成任务的历史缓存,保持软件运行流畅。
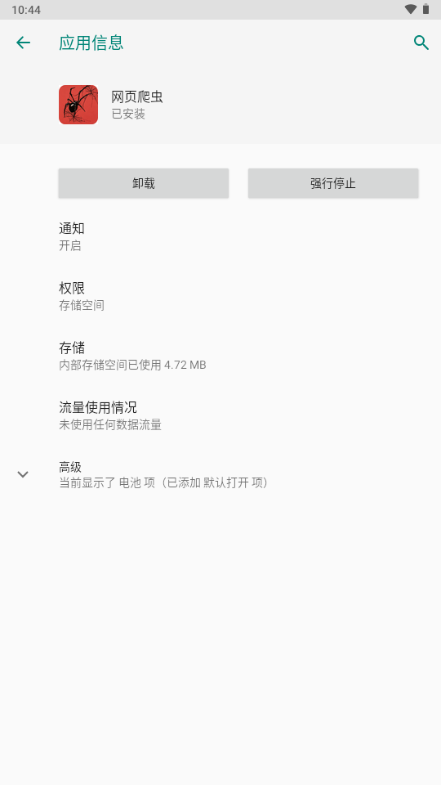
移动端使用时,需在系统设置中允许网页爬虫访问存储空间,否则导出的数据文件无法保存到本地;部分安卓机型会对后台运行的应用进行限制,建议将软件加入电池优化白名单,避免采集过程中被系统强制中断。
电脑端运行时,若出现界面卡顿或闪退,可尝试关闭其他占用内存较大的程序,或检查软件是否为最新版本;若采集结果为空,优先检查目标网址是否可正常访问、字段规则是否匹配当前页面结构。遇到依赖组件缺失提示时,可在站内搜索“运行库合集”获取对应组件安装包。
无论移动端还是电脑端,都建议在采集前确认目标网站的robots协议与使用条款,仅在允许范围内采集公开信息,尊重网站运营者的合法权益。
| 软件名称 | 功能优势 | 评分 |
|---|---|---|
| 八爪鱼采集器 | 模板丰富,云端采集省心 | ★★★★★ |
| 后羿采集器 | 智能识别,操作简单直观 | ★★★★☆ |
| 商讯视界采集器 | 批量导出,办公场景友好 | ★★★★☆ |
| 火车采集器 | 规则灵活,支持复杂站点 | ★★★★☆ |
| 紫薇采集器 | 轻量免费,适合入门尝试 | ★★★☆☆ |
| 数据堂采集器 | 数据清洗,结果规整好用 | ★★★★☆ |
网页爬虫本身是一款本地运行的数据采集辅助工具,软件不包含恶意代码与捆绑插件,安装包体积小巧,运行过程中不会主动上传用户采集到的数据到外部服务器,采集结果仅保存在用户本地设备中。用户从正规下载站获取安装包后,按照系统提示完成安装即可正常使用。需要留意的是,软件的安全性不仅取决于程序本身,也与使用方式密切相关,建议用户仅采集公开可访问的网页信息,遵守目标网站的使用条款与相关法律法规,不将采集数据用于侵犯他人权益的用途,这样使用网页爬虫是安全且合规的。
网页爬虫的核心定位是网页文本与结构化数据的采集工具,主要针对标题、链接、图片地址、正文内容等字段进行提取,并不直接提供视频流下载功能。如果用户需要保存网页中的视频,可以通过网页爬虫采集视频页面的链接地址或视频源文件URL,再配合专门的下载工具完成保存。具体操作时,在网页爬虫中配置采集规则,将视频页面的链接字段提取出来并导出为文本文件,然后使用下载软件批量导入链接进行下载。需要提醒的是,下载视频应尊重版权方权益,仅保存自己拥有合法访问权限的内容,切勿将下载的视频用于商业传播或二次分发。
包名:org.example.webcrawler
MD5值:76e4479b2738774ff466ba618b0ab5e4
SysKit2.28.55 系统工具集
立即下载
泰找房3.6.56 找房看房工具
立即下载
诚服务26.09.30 综合服务平台
立即下载
nexus_download0.1.0 极速下载工具
立即下载
当当狸1.8.2 智能硬件管理
立即下载
RelayGo1.0.3 中继加速
立即下载
图片压缩器(Image Compressor)7.0 图片压缩工具
立即下载
小橘猫宠物翻译3.0.2.302 宠物语言翻译
立即下载
LivePlayer1.0 实时直播播放
立即下载
超级好用计算器4.4 便捷计算工具
立即下载
压缩包密码恢复工具(ZipCracker)8.1 密码恢复解密
立即下载
启明星工具箱2.1 手机工具集
立即下载
水印相机免费拍照记录1.0.0 拍照打卡水印工具
立即下载
哆啦云注入5.2.0 云端注入工具
立即下载 灵当CRM3.2.3 客户管理专家
立即下载
 扫描全能王手机免费版v7.27.5.2610150000 官方安卓版
立即下载
 大数跨境1.0.10 跨境出海一站式APP
立即下载
 ROI计算器1.0.12 电商盈亏测算
立即下载
 扫呗SaoBei4.6.18.0 一站式聚合收款工具
立即下载
 思必驰闪记3.0.0.26100804 智能语音笔记
立即下载
 电子税务发票通助手1.0.3 电子发票管理工具
立即下载
 金山WPS Office appv26.10.0 安卓版
立即下载
 智联招聘app下载安装v8.15.13 官方最新版
立即下载
 腾讯妙思1.3.1 AI视频创作
立即下载
 探探app下载安装2026手机版v7.4.1 安卓版聊天通讯立即下载
 中油好客e站电子加油卡充值优惠下载v3.9.0 安卓版生活实用立即下载
 快手app官方版v14.9.20.50799 安卓版影音播放立即下载
 WiFi万能钥匙下载官方免费下载v5.2.50 安卓版系统软件立即下载
 快手下载最新版2018v14.9.20.50799 安卓版图像拍照立即下载
 腾讯全民K歌下载免费2026v11.2.38.278 安卓版影音播放立即下载
 唯品会官方免费版下载v9.86.4 最新安卓手机版购物比价立即下载
 BeautyCam美颜相机官方免费下载v13.3.80 安卓版图像拍照立即下载
 旗鱼影音
 kitscream
 急借通
 梦享金
 鄂公网安备42011102004716号